
Optimal Workshop'un milyonlarca ağaç testi görevinden derlediği kendi veri seti, şu kayıtları tutmaktadır: Doğru ilk tıklama sonrasında görev başarı oranı %70, yanlış tıklama sonrasında ise %24'tür.Bir kişinin seçtiği ilk etiket, sonucun büyük bir kısmını belirler. Ancak bu sayı size hangi çalışmayı yürütmeniz gerektiğini söylemez. Ekipler, zaten bir menüye sahip olduklarında ve yalnızca kelime seçiminden şüphe duyduklarında kart sıralama yaparlar, kelime dağarcığı hiç kontrol edilmemiş bir yapıyı ağaç testiyle denetlerler ve ardından soruyu asla çözmeyecek sonuçlar hakkında tartışırlar. Bu kılavuz, gezinme problemi olan ve sabit bir araştırma bütçesine sahip UX liderleri, ürün yöneticileri ve CRO ekipleri içindir. Sonunda, bir gezinme kararını üç yöntemden birine eşleştirebilecek, çalışmanın boyutunu belirleyebilecek, veri toplamadan önce bir geçme eşiği belirleyebilecek ve sonucun neyi kanıtlayamayacağını belirtebileceksiniz.
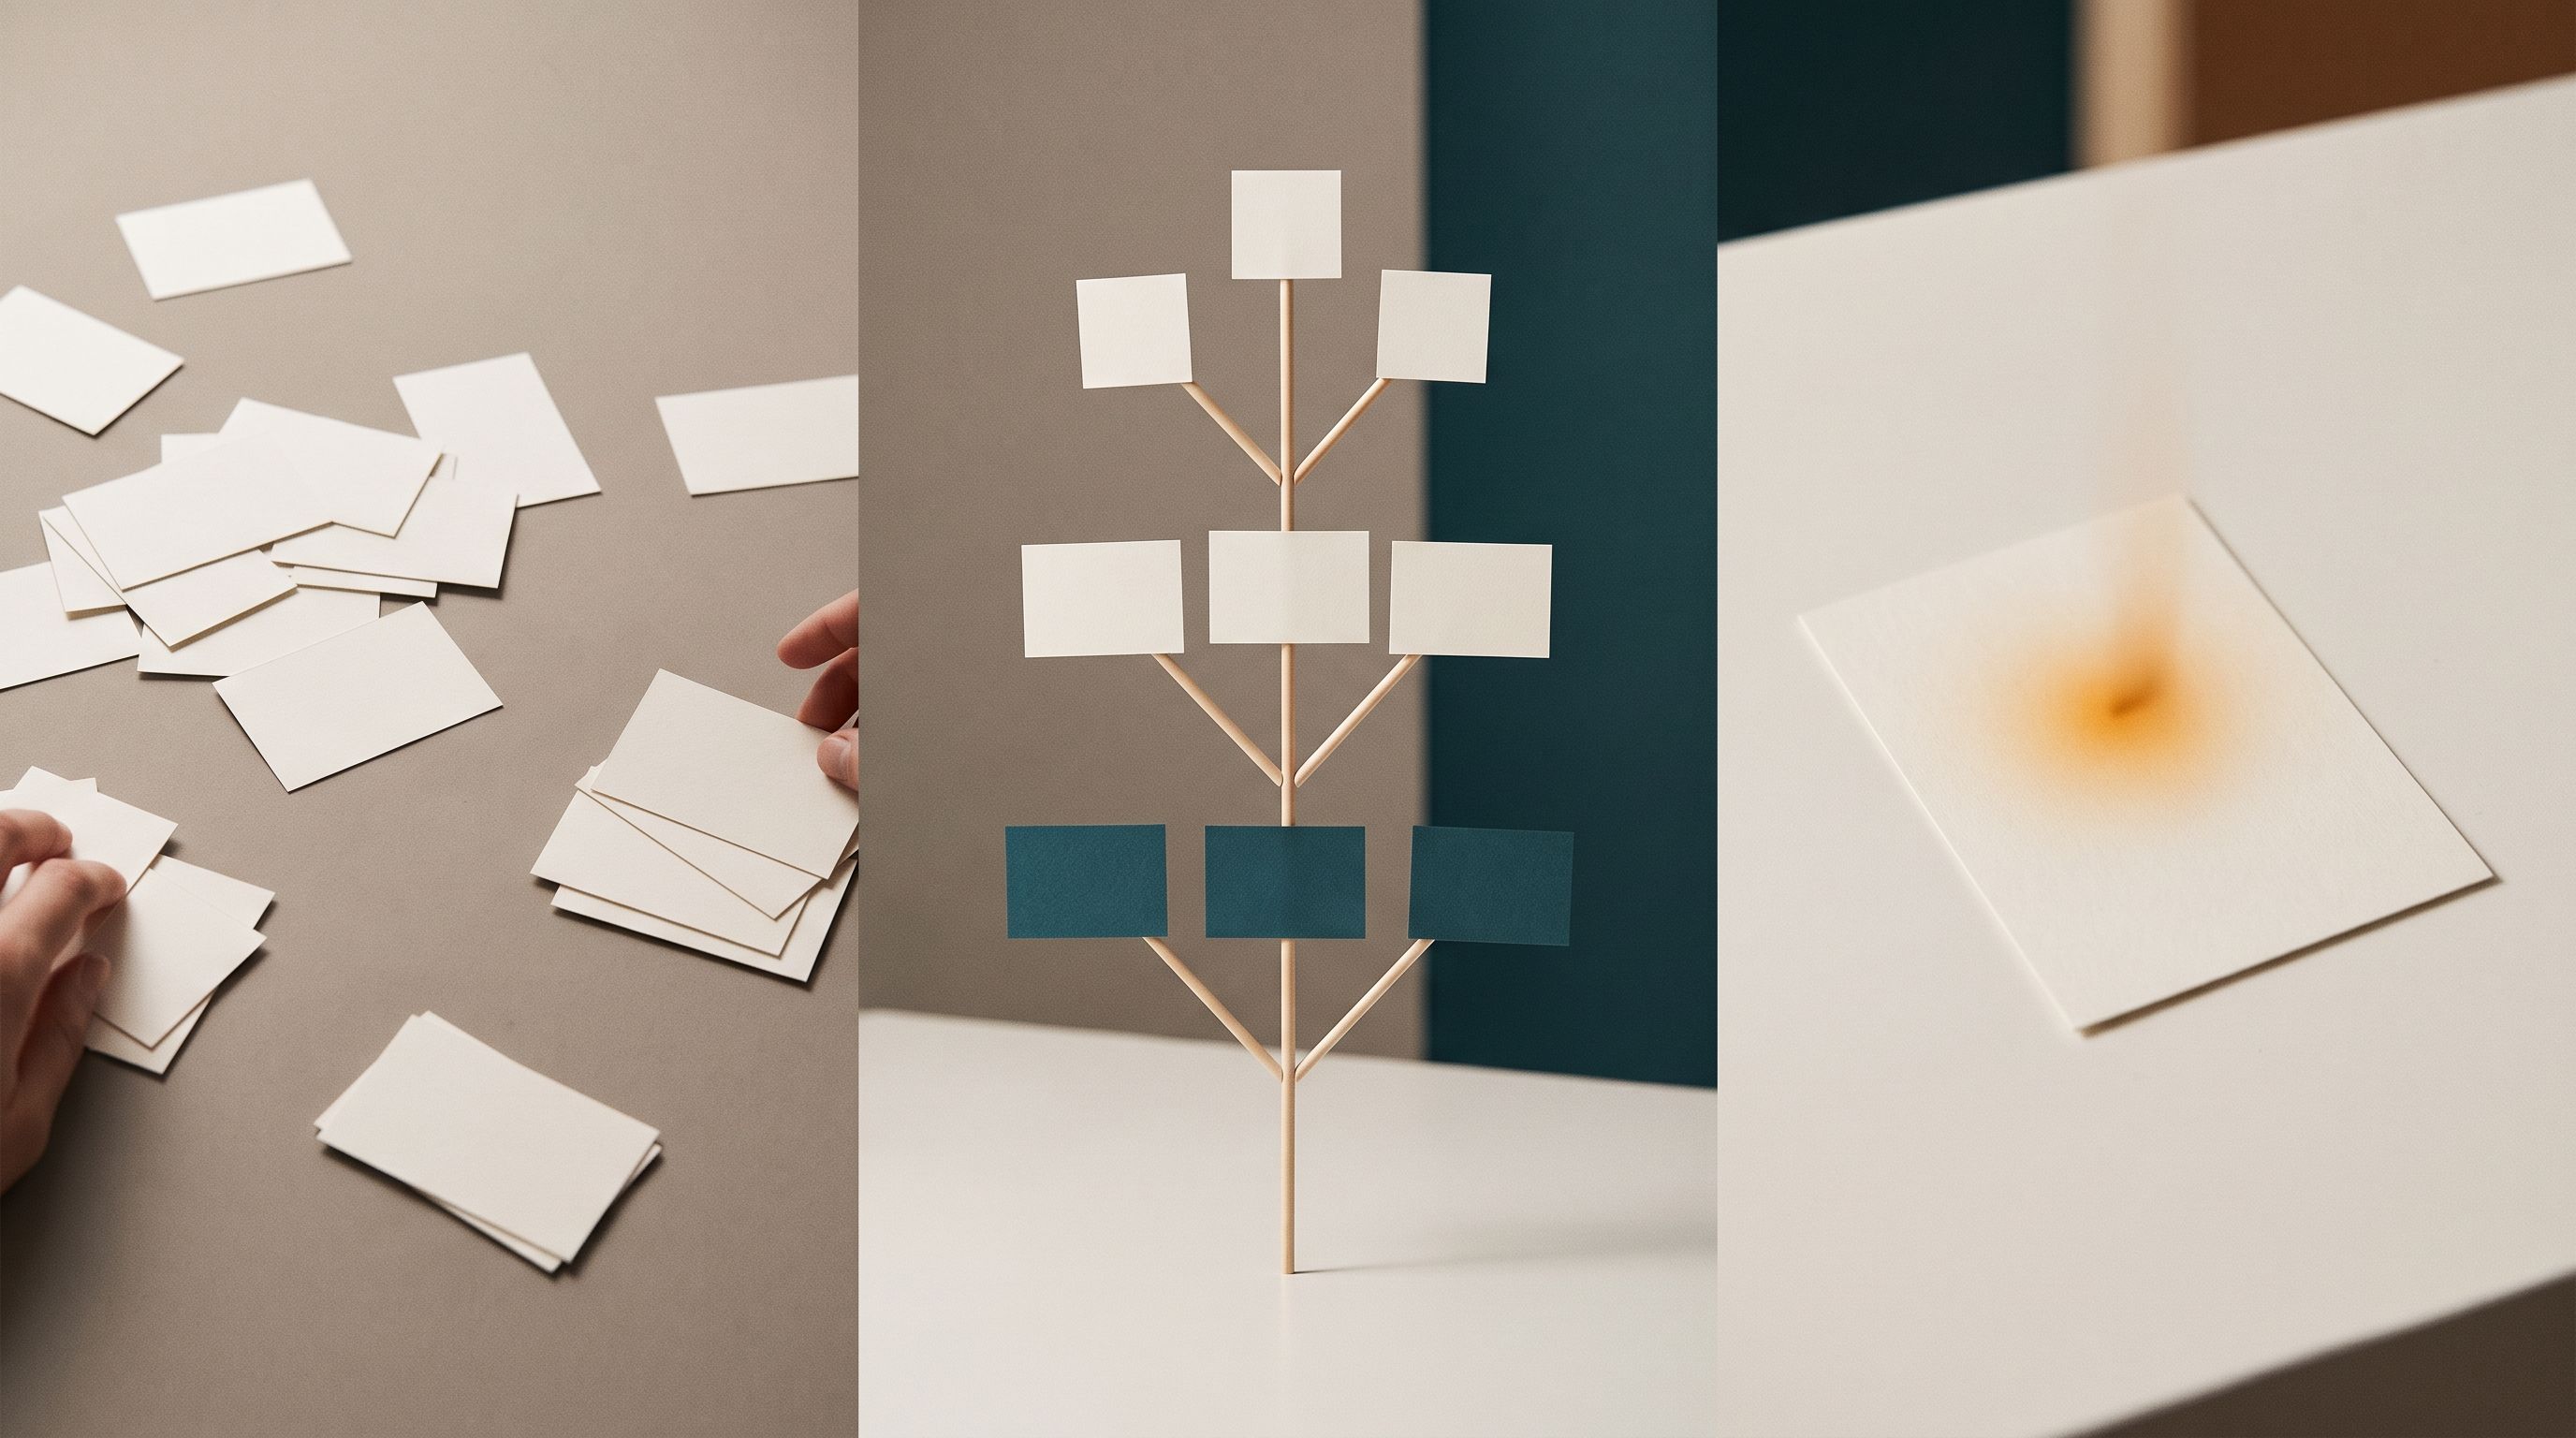
Bu üç yöntem üç farklı soruyu yanıtlıyor.
Kart sıralama yöntemi üretken bir yöntemdir. İnsanlara içerik öğelerinizi verirsiniz ve grupları oluşturup adlandırmalarına izin verirsiniz. Bu yöntem, hedef kitlenizin alanı nasıl bölüştürdüğünü ve hangi kelimeleri kullandığını size gösterir. Ancak, çalışmada menü olmadığı için belirli bir menünün işe yarayıp yaramadığını size söyleyemez.
Ağaç testi değerlendirici bir yöntemdir. Önerilen hiyerarşiyi yalnızca metin etiketlerine indirgersiniz, insanlara bir görev verirsiniz ve nereye gittiklerini izlersiniz. Bu, bir yapının bulunabilir olup olmadığını ve hangi dalın insanları yuttuğunu size söyler. NN/g'nin belirttiği gibi, yalnızca metin ayarı, yerleşimi, rengi ve görselleri kasıtlı olarak ortadan kaldırır, böylece etiket ve yapı kalitesini izole eder.
İlk tıklama testi daha dar kapsamlıdır. Tek ekran, tek görev, tek kaydedilmiş tıklama. Giriş noktasının doğru okunup okunmadığını bir bakışta gösterir, ancak iki seviye aşağıda neler olup bittiği hakkında hiçbir bilgi vermez.
Yanlış olanı çalıştırmak en yaygın hatadır. "Kimse iade politikasını bulamıyor" bir kart sıralama sorusu değildir. "'Çözümler'in alıcılar için bir anlam ifade edip etmediğini bilmiyoruz" bir ağaç testi sorusu değildir; bir ağaç testi yalnızca tahmininizi ölçer.
Kriter tablosu: Lisansına sahip olduğunuz araca göre değil, karara göre seçim yapın.
| Kriter | Kart sıralama | Ağaç testi | İlk tıklama testi |
|---|---|---|---|
| Soruyu cevaplıyor | İnsanlar bu içeriği nasıl gruplandırır ve adlandırır? | İnsanlar bu yapının içinde bir şeyler bulabilir mi? | Giriş noktası ilk bakışta doğru anlaşılıyor mu? |
| Menşei | üretken | Değerlendirici, nicel | Değerlendirici, nicel |
| Mevcut bir yapıya ihtiyaç duyar. | Yok hayır | Evet, en azından bir taslak. | Evet, bir ekran veya tel çerçeve. |
| Tipik katılımcılar | Minimum 15, yüksek bahisler için 30 | Nicel okuma için ağaç başına 50'den fazla | Ekran başına 50'den fazla varyant |
| Birincil ölçütler | Anlaşma ve birlikte görülme, etiket sıklığı | Başarı oranı, doğrudanlık, ilk tıklama, süre | İlk tıklama doğruluğu, tıklama ısı dağılımı |
| Üzerinde işlem yapabileceğiniz çıktı | Aday kategorileri ve kullanıcı sözlüğü | Kırık dalların ve etiketlerin sıralı listesi | Bir etiket veya tasarım seçimi hakkında bir değerlendirme |
| Nerede yanıltıcıdır? | Bireyler farklı gruplara ayrılır; çözüm için muhakeme gerekir. | Görünür bir kokusu yok, bu yüzden kötü tasarımları daha da güzelleştiriyor. | Kurtarma işlemini göz ardı eder; yanlış bir ilk tıklama her zaman görevin kaybedilmesi anlamına gelmez. |
Karar kuralları
- Hiçbir yapı yok, ya da kimsenin inanmadığı bir yapı. Önce kart sıralama yapın — kelime bilgisi istiyorsanız açık, en üst seviye sabitse ve sadece yerleştirme söz konusuysa kapalı yöntem kullanın.
- İki aday yapı ve bir türlü bitmeyen bir toplantı. Ağaç testi her ikisini de yapar. Üç testten yapısal bir argümanı sayıyla çözen tek test budur.
- Trafik geliyor ama sonraki tıklama yanlış. Ekranı ilk tıklamada test edin. Tek bir etiketi düzeltmek için mimariyi yeniden oluşturmayın.
- Analizler, insanların hangi bölgelerden ayrıldığını zaten gösteriyor. Keşif aşamasını atlayın. Sızıntı yapan dalı ağaç testiyle kontrol edin, ardından yedek etiketi ilk tıklama testiyle kontrol edin.
- Yeni pazar veya dil. O pazardaki katılımcılarla o dilde kart sıralama oyunu oynayın. Tercüme edilmiş bir menü, denenmemiş bir menüdür.
İncelemede savunabileceğiniz örneklem büyüklükleri ve eşikler
Kart sıralama yöntemi için Tullis ve Wood, 168 kullanıcıyı test etmiş ve rastgele alt kümeleri analiz etmiştir. Tam örneklem sonucuyla korelasyon, 5 kullanıcıda 0.75, 15 kullanıcıda 0.90, 20 kullanıcıda 0.93, 30 kullanıcıda 0.95 ve 60 kullanıcıda 0.98 olmuştur. Nielsen bunu şöyle yorumluyor: 15, durmanın rahat olduğu nokta; 30 ise iyi finanse edilmiş projeler için. Kullanılabilirlik testindeki beş kullanıcı kuralı burada geçerli değil; üretken bir yöntem, modelin istikrar kazanması için yeterli sayıda insana ihtiyaç duyar.
Ağaç testleri için NN/g, ağaçlar arasında anlamlı bir karşılaştırma için ağaç başına 50 veya daha fazla katılımcı önerir ve 98 çalışma üzerinden Albert ve Tullis'in bantlarından geçme eşiklerini belirler: %40'ın altında zayıf, %41-60 arası orta, %61-80 arası iyi, %80-90 arası çok iyi, %90'ın üzeri mükemmel. Verileri görmeden önce eşik üzerinde anlaşın. Kritik görevler (ödeme, iade, randevu alma) %90'ı geçmelidir; tanıtım amaçlı bir göz atma görevi %70'te kalabilir.
Doğrudanlığı başarıyla birlikte okuyun, asla onun yerine değil. Düşük doğrudanlıkla yüksek başarı, insanların rastgele yollardan ilerleyerek vardıkları anlamına gelir: yapı varlığını sürdürse bile etiket yanlıştır. Bu örüntü, bir ağaç testinin ürettiği en kullanışlı sinyaldir.
Çalışılmış örnek
"Sağlık" başlığı altında en üst düzeyde bir ürün ve onun altında gizlenmiş bir destek makalesi bulunan çevrimiçi bir eczane. Rakamlar örnek niteliğindedir, müşteri verileri değildir.
- Ağaç testi, 60 katılımcı, 8 görev. "Reçetenizin karşılanıp karşılanmadığını öğrenin." Başarı oranı %58, açıklık oranı %22 - puanlamada orta düzeyde, açıklık oranındaki fark ise etikette yer alıyor.
- İlk tıklama tablosunu okuyun. %41'i "Sağlık", %33'ü "Destek", %18'i "Hesap" kategorisine yönelmiş: üç olası kategori, kategori sınırının kullanıcıların zihninde olmadığını gösteriyor.
- Kapalı kart sıralama oyunu, 20 katılımcıMakale başlıklarını ve mevcut üst düzey yapıyı kullanarak. Eğer haber maddeleri üç gruba dağılmışsa, sorun üst düzeydedir, kelime seçiminde değil.
- Yeniden yazın ve yeniden test edin. Yeni ağaç, aynı 8 görev, 60 yeni katılımcı. Hedef başarı oranı %80'in üzerinde ve doğrudanlık oranı %60'ın üzerinde.
- Yeni etiketi ilk tıklamada test edin. Gönderimden önce gerçek sayfada. Ağaç testinde görsel bir koku yoktu; canlı sayfada var.
[DAHİLİ VERİLER GEREKLİ: Bu örnek diziyi, başarı ve doğrudanlık rakamları ile görev sayısı da dahil olmak üzere, kimliksizleştirilmiş bir Switas ağaç testi öncesi/sonrası verileriyle değiştirin.]
Türkçe etiketler ve bölgesel durumun neden kozmetik olmadığı
Türkçe ve bazı komşu dillerde etiket testini zorlaştıran iki şey var ve bu iki şey, sadece bölgeden satış yapanlar için değil, bölgeye satış yapan herkes için önem taşıyor.
Öncelikle, Türkçe eklemeli bir dildir: anlamlar kök üzerine ekler şeklinde birikir, bu nedenle İngilizce'de iki kısa kelime olan bir kategori Türkçe'de genellikle tek bir uzun kelime olur. İngilizce'de sığan menüler taşar ve ekipler bunu kısaltarak düzeltir; bu da tam olarak bir ağaç testinin ölçtüğü değişkendir. Test etiketlerini gerçekte görüntülenecekleri uzunlukta test edin.
İkincisi, Türkçede dört tane I harfi vardır: noktalı İ (U+0130) ve i (U+0069), noktasız I (U+0049) ve ı (U+0131). Türk kurallarına göre, küçük harf. i ile eşleşir İ, değil IBu nedenle, İngilizce için yazılmış büyük/küçük harf duyarsız eşleştirme başarısız olur; "iptal" araması, kayıtlı "IPTAL" ile eşleşmez. Site araması, filtre çipleri veya yol gösterici büyük/küçük harf kullanımı, yerel ayardan bağımsız büyük harf çağrısından geçerse, kullanıcılar mevcut bir terim için boş bir sonuç kümesi alırlar. Etiketi suçlamadan önce bunu eleyin.
Ayrıca uyumluluk açısından da bir avantaj söz konusu. WCAG 2.2 Başarı Kriteri 2.4.6, Başlıklar ve Etiketler, AA seviyesindedir ve başlıkların ve etiketlerin konu veya amacı açıklamasını gerektirir. %40 başarı oranıyla test edilen bir etiket, yalnızca bir dönüşüm sorunu değil; aynı zamanda uygunluk iddiasına karşı bir kanıttır.
Bu rakamların kanıtlamadığı şey
Burada en çok alıntı yapılan rakam, Bailey ve Wolfson'ın 2006-2009 yılları arasındaki çalışmasından elde edilen, ilk tıklamada doğru sonuç alınması durumunda %87, yanlış sonuç alınması durumunda ise %46 olan görev başarı oranıdır. Buna dikkatli yaklaşın: Optimal Workshop'un kendi, çok daha büyük veri seti aynı karşılaştırma için %70 ve %24 oranlarını vermektedir. Yön aynı, büyüklükler ise önemli ölçüde farklı; ve her ikisi de araç içinde ölçülen korelasyonlardır, bir tıklama testinin canlı site davranışını tahmin ettiğinin kanıtı değildir.
Bu noktada, Sauro, Schiavone, Du ve Lewis 2023 yılında 130 katılımcıyla statik görüntülerdeki ilk tıklamaları canlı sitelerle karşılaştırdı: davranışlar benzerdi, sıcak nokta bölgelerinde ortalama %6'lık mutlak bir fark vardı. Ayrıca, sonraki aşamalardaki görev başarısını ölçmediklerini ve duyarlı düzenlerin ve fareyle üzerine gelindiğinde açılan menülerin gerçek tutarsızlıklar yarattığını belirttiler. Dürüst iddia, tıklama testlerinin insanların nereye tıkladığını yeniden ürettiğidir, insanların işlemi tamamlayıp tamamlamayacağını tahmin etmediğidir.
Ağaç testinin de benzer bir sakıncası var. Kuric, Demcak ve Krajcovic, 180 katılımcı ve 1,800 görev üzerinden aynı mimariye sahip yüksek doğruluklu prototiplere karşı üç ağaç testi varyantını karşılaştırdı ve varyantlar birbirleriyle uyuşmadı; ağaç görünür varyantı prototip davranışını en yakından takip etti ve geri izleme metrikleri önemli ölçüde farklılık gösterdi. Aracınız ağacı, kıyaslama verisinin geldiği ağaçtan farklı şekilde oluşturuyorsa, kıyaslama verisi aktarılamaz.
Bu durumun bozulduğu nokta
- Arama motorlarında en çok kullanılan siteler. Eğer oturumların çoğu arama kutusunda başlıyorsa, az kişinin kullandığı bir yolu optimize ediyorsunuz demektir. Öncelikle arama olayı içeren oturumların oranını kontrol edin.
- Kişiselleştirilmiş navigasyon. Ağaç yapısı testi, sabit bir hiyerarşi varsayar. Menü segmentlere göre farklılık gösteriyorsa, kurgusal bir yapıyı test ediyorsunuz demektir.
- Çok küçük nüfuslar. B2B ve klinik kitleler genellikle 50 nitelikli katılımcı sağlayamazlar. Yüzdeler yerine sayıları bildirin ve bunu belirtin.
- Üç testin hiçbiri anlama becerisini ölçmüyor. Bulduklarını değerlendiriyorlar, bulduktan sonra anlamayı değil. Bunun için kullanılabilirlik testi gerekiyor.
- Bunların hiçbiri geliri ölçmüyor. Bir navigasyon düzeltmesi, kanıtlanmış bir kaldırma yöntemi değil, bir deney için bir hipotezdir. Bunu bir testin ardından gönderin.
Sık Sorulan Sorular
Aynı katılımcılar üzerinde hem kart sıralama testi hem de ağaç testi uygulayabilir miyim?
Aynı oturumda değil. Sıralama, insanlara modelinizi öğretir, böylece yeni bir ziyaretçinin bulamayacağı şeyleri bulurlar. Ayrı gruplar oluşturun veya aralarında birkaç hafta bırakın.
Kart sıralama etkinliği için kaç katılımcıya ihtiyacım var?
Tullis ve Wood verilerinde tam örneklem sonucuyla 15, 0.90'lık bir korelasyon sağlarken, 30 ise 0.95'lik bir korelasyon sağlıyor. 15'in altında desen istikrarsız. 30'un üzerine çıkmak ise maliyete karşılık çok az şey kazandırıyor.
Bir ağaç testi için gerçekten 50 katılımcı gerekli mi?
İki ağaç arasında niceliksel bir karşılaştırma için evet, bu NN/g'nin önerisidir. Sadece bariz şekilde kırık dalları bulmak istediğiniz tek bir ağaç için 20 ila 30 dal en kötü durumdaki dalları ortaya çıkaracaktır, ancak yüzdeler yerine sayıları raporlayın.
Geçme notu olarak ne sayılır?
Acele etmeden önce karar verin. Albert ve Tullis ölçeklerini varsayılan olarak kullanın: %80'in üzeri çok iyi, %61-80 arası iyi, %40'ın altı ise kötü. Para, ilaç veya yasal haklarla ilgili görevler için çıtayı %90'a yükseltin.
Başarı oranı yüksek ama doğrudanlık düşük. Neyi düzeltebilirim?
Sorun etikette, yapıda değil. İnsanlar keşif yaptıktan sonra doğru yere ulaşıyorlar, bu da kategorinin modellerinde var olduğu ancak sizin kullandığınız kelimelerin bunu işaret etmediği anlamına geliyor. Etiketi yeniden yazın ve aynı görevleri tekrar test edin.
Yapay zekâ araçları katılımcılara olan ihtiyacı ortadan kaldırır mı?
Bu yöntemler için geçerli değil. Bunlar belirli bir popülasyonun neye inandığını ve ne yaptığını ölçer; bir modelin o popülasyon hakkındaki tahmini bir hipotezdir, veri değildir. Modelleri görevleri tasarlamak ve açık uçlu etiketleri daha hızlı kümelemek için kullanın.
Sonraki adım
Eğer navigasyon argümanı analizinin çözemediği bir sorun varsa, en ucuz çözüm, önceden kararlaştırılmış eşiklerle her iki aday yapı üzerinde bir ağaç testi yapmaktır. Görevleri yazın, ölçütleri belirleyin ve çalıştırın — veya Bunu bizim yapmamıza izin verin ve size kırık dalların sıralı listesini verelim.
kaynaklar
- Jakob Nielsen, Kart Sıralama: Kaç Kullanıcıyla Test Edilmeli, Nielsen Norman Group, 2004
- Tom Tullis ve Larry Wood, Bir Kart Sıralama Çalışması İçin Kaç Kullanıcı Yeterlidir?, UPA 2004
- Page Laubheimer, Ağaç Testi Bölüm 2: Sonuçların Yorumlanması, Nielsen Norman Group, 19 Ocak 2024
- Samhita Tankala, Kart Sıralama ve Ağaç Testi Karşılaştırması, Nielsen Norman Group, 23 Şubat 2024
- Nielsen Norman Group, Ağaç Tabanlı Test: Menü Etiketlerini ve Kategorilerini Değerlendirme
- Optimal Workshop, Doğru İlk Tıklamalar Görev Başarısını 3 Kat Artırıyor, 13 Nisan 2015
- Jeff Sauro, Will Schiavone, David Du ve Jim Lewis, Tıklama Testleri Canlı Site Tıklamalarını Tahmin Edebilir mi?, MeasuringU, 21 Mart 2023
- Eduard Kuric, Peter Demcak ve Matus Krajcovic, Bilgi mimarisinin doğrulanması: Ağaç testi varyantlarının ve prototip kullanıcı testinin çapraz metodolojik karşılaştırması, Bilgi ve Yazılım Teknolojisi 183, Temmuz 2025
- W3C, Başarı Kriteri 2.4.6'yı Anlamak: Başlıklar ve Etiketler, WCAG 2.2
- Tex Texin, Türkçeyi Uluslararasılaştırmak: Noktalı ve Noktasız Türkçe I Harfi













